端侧AI与低延迟
推理任务尽量留在设备本地执行,减少往返云端的时间开销,让语音唤醒、视觉识别这类交互更贴近即时反馈。
推理任务尽量留在设备本地执行,减少往返云端的时间开销,让语音唤醒、视觉识别这类交互更贴近即时反馈。
同时处理语音、图像与传感器信号,让设备理解上下文,而不是只对单一指令做出机械应答。
把设备能力封装成可被调度的工具接口,由 Agent 按场景组合调用,从被动响应转向有条件的主动提醒。
遵循统一互联标准接入照明、门锁、传感器等品类,降低不同品牌设备之间的协同门槛。
敏感数据优先本地处理与脱敏,传输链路加密,权限按最小必要原则授予,并保留可审计的操作记录。
提供设备接入、模型部署与云端协同的开放接口,方便方案商与开发者按自身节奏完成集成。
Bwin 是一个面向 AI 芯片与智能设备领域的内容与选型平台,围绕端侧AI、AI Agent、多模态交互、AIoT、Matter/Thread、边缘计算与隐私计算等方向,整理可被工程师和产品经理直接使用的资料。
我们把芯片参数、设备形态与真实使用场景放在一起讨论:一颗 NPU 的算力档位意味着什么,RISC-V 架构在端侧部署中有哪些取舍,存算一体在功耗上带来怎样的变化,这些问题在页面上都有对应的解释与对照。
内容坚持真实、客观、科学的原则,不夸大性能,不承诺无法验证的结果。涉及行业趋势的表述会标明其讨论范围,涉及技术细节的段落尽量给出可查证的背景,方便读者自行判断。
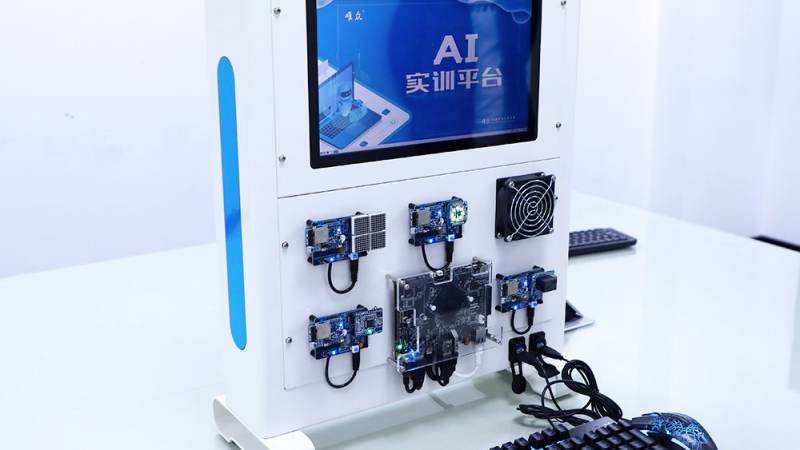
参照主流信息安全管理体系与隐私保护框架梳理内部流程,对数据采集、存储与调用环节设置分级管控,并定期复核权限配置。
内容团队跟踪芯片架构、端侧模型压缩与互联标准的公开进展,交叉核对来源后再成稿,减少二手转述带来的偏差。
接入与使用过程中的问题可通过邮箱与电话反馈,值班人员按优先级响应,复杂问题会转交对应方向的技术同事跟进。
从芯片参数与设备形态两条线索出发,建立基础术语表与选型框架,解决新手看不懂规格表的问题。
围绕端侧推理、模型量化与 NPU 调度开设专题,把分散的技术点串成可循序渐进阅读的路径。
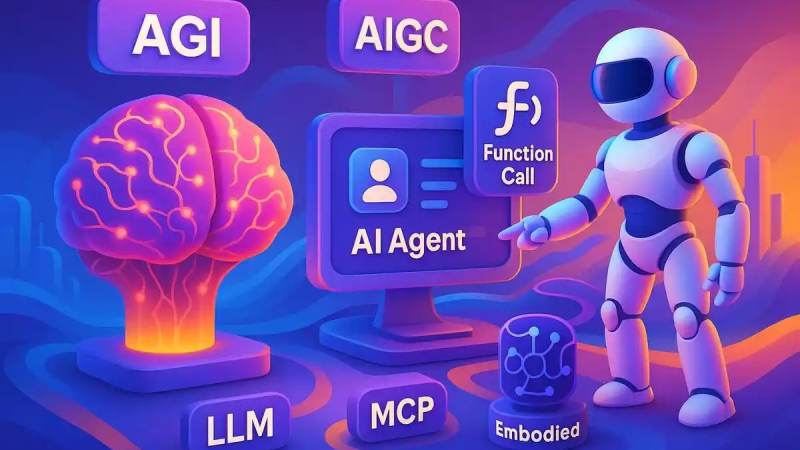
补充 Agent 工具调用、多模态输入输出与上下文管理的实践说明,覆盖从芯片到应用的完整链路。
整理 Matter/Thread 等互联标准下的设备接入方式,说明协议差异对实际组网体验的影响。
持续跟踪隐私计算与边缘计算在设备侧的落地方式,同步更新选型指南与接入步骤文档。
 julimystar.top
按算力、功耗、内存带宽与开发生态整理对照表,帮助在方案早期快速缩小候选范围。
梳理工具注册、意图路由与失败回退的处理方式,让 Agent 在设备端稳定运行而不依赖单次网络请求。
针对语音与视觉同时输入的场景,给出时序对齐、降噪与误触发抑制的调参思路。
说明 Thread 边界路由器部署、Matter 设备配网流程与跨品牌联动中的常见冲突排查方法。
从数据分级、本地脱敏到联邦学习可行性评估,给出符合实际算力条件的取舍建议。
 julimystar.top
参数规模与内存带宽的平衡成为关键,量化与稀疏化方案被更多方案商纳入默认选项。
当语音唤醒与视觉识别同时运行时,任务优先级与内存复用策略会明显影响首帧延迟。
应用层标准与网络层协议各司其职,理解边界路由器角色有助于排查设备离线问题。
把计算单元靠近存储可以减少数据搬运开销,但工艺与工具链成熟度仍是落地变量。
受限于体积与散热,端侧算力与云端协同的比例需要按使用频次重新设计。
指令扩展与编译器支持逐步完善,但算子库覆盖度仍是选型时需要确认的细节。
AI芯片 · GPU 与端侧推理平台
AI芯片 · 移动与边缘计算平台
AI芯片 · 端侧算力与连接方案
智能家居 · 设备互联与生态接入
语音技术 · 语音识别与合成
物联网平台 · 云服务与设备管理
先在设备端完成配网,再在管理入口按品类添加。建议按房间分组命名,便于后续设置自动化规则时快速定位。
通知开关位于账户设置的消息偏好中,可按设备类型分别订阅。退订同样在该页面操作,关闭后仍可在设备详情里手动检查更新。
支持。常用场景可以收藏到首页快捷区,自动化规则可保存为模板,方便在同类设备上复用。
敏感数据优先在本地完成处理,仅上传必要的结果字段;传输链路加密,权限按最小必要原则授予,操作记录可查询。
可接入主流语音助手与多类端侧、云端大模型,具体支持范围取决于设备算力与厂商适配进度,选型时建议先确认模型体积与推理时延要求。
选型对照表做得很细,功耗和接口那两列帮我们在方案评审时省了不少来回确认的时间。
关于端侧推理延迟的说明比较克制,没有夸张数字,给出的测试条件也写清楚了,这点很难得。
Matter 组网那篇帮我解决了边界路由器位置的问题,设备掉线的频率明显降下来了。
接入指南的步骤写得像手册,按顺序走一遍基本能跑通,遇到报错也能在排查清单里找到对应项。
隐私计算那部分讲得比较务实,没有把联邦学习说得万能,反而给出了算力不足时的替代思路。
资讯更新节奏稳定,术语解释到位,团队里的新人可以自己先看一遍再来讨论,沟通成本低了不少。
 julimystar.top
按本地推理、图像处理与多任务并发三类负载,分别给出算力档位的参考区间。
量化位宽、KV 缓存管理与内存占用之间的关系,决定了端侧模型能不能常驻运行。
节点放在哪里会影响时延与覆盖,结合户型与设备密度可以给出更合理的布点方案。
把推理任务按频次分层,高频轻量任务留在本地,低频重任务择机上传,是常见的折中做法。
从唤醒词阈值、环境噪声到视觉确认条件,逐项排查往往比直接更换模型更有效。
为每个工具定义明确的超时与降级路径,可以避免单点失败影响整体交互体验。